Techniküberarbeitet
Wie dieser Blog gebaut ist und läuft
Ein Blick unter die Haube: Astro im Server-Modus, PostgreSQL mit Drizzle, eine Redaktions-Schnittstelle, die nichts veröffentlichen kann, und die Kette vom Git-Tag bis zur laufenden Version.
Dieser Blog ist kein Baukasten und kein fremder Dienst, den ich nur eingerichtet habe. Er läuft auf einem eigenen kleinen Server, und ich habe fast jede Zeile davon selbst geschrieben oder zumindest bewusst ausgewählt. Der Reiz daran ist nicht, dass es besonders schnell oder besonders bunt wäre — sondern dass ich jede Entscheidung nachvollziehen kann. Wenn hier etwas kaputtgeht, weiß ich, wo ich suchen muss. In diesem Beitrag erzähle ich, wie das Ganze zusammenhängt: von der Software, die die Seiten ausliefert, bis zu dem Mechanismus, der am Ende dafür sorgt, dass eine neue Version tatsächlich online landet.
Astro, und zwar im Server-Modus
Der Blog läuft mit Astro 7, aber nicht in der Variante, die viele zuerst kennenlernen: als Generator, der einmal einen Ordner mit fertigen HTML-Dateien ausspuckt. Hier läuft Astro im Server-Modus, mit dem Node-Adapter im Modus standalone. Das bedeutet: der Blog ist ein eigener, dauerhaft laufender Node-Prozess, der bei jeder Anfrage neu entscheidet, was er ausliefert.
Das war nicht immer so. Am Anfang lagen die Beiträge als Markdown-Dateien direkt im Repository. Das hat eine Weile gut funktioniert, aber irgendwann wurde klar: Ich wollte schreiben können, ohne dafür Git zu benutzen, ohne ein Deployment anzustoßen — im Idealfall auch vom Telefon aus, wenn mir unterwegs etwas einfällt. Also wanderten die Beiträge in die Datenbank. Heute wird bei jeder Anfrage aus der Datenbank gelesen, das Markdown zur Laufzeit gerendert und Codeblöcke werden von Shiki eingefärbt. Ein kleiner Nebeneffekt dieser Entscheidung, den ich konsequent durchgezogen habe: Adressen enden hier immer auf einen Schrägstrich, /technik/mein-beitrag/ statt /technik/mein-beitrag. Klingt nach Kleinigkeit, aber wenn man das nicht von Anfang an festlegt, bekommt man irgendwann doppelte Adressen für dieselbe Seite.
PostgreSQL und Drizzle
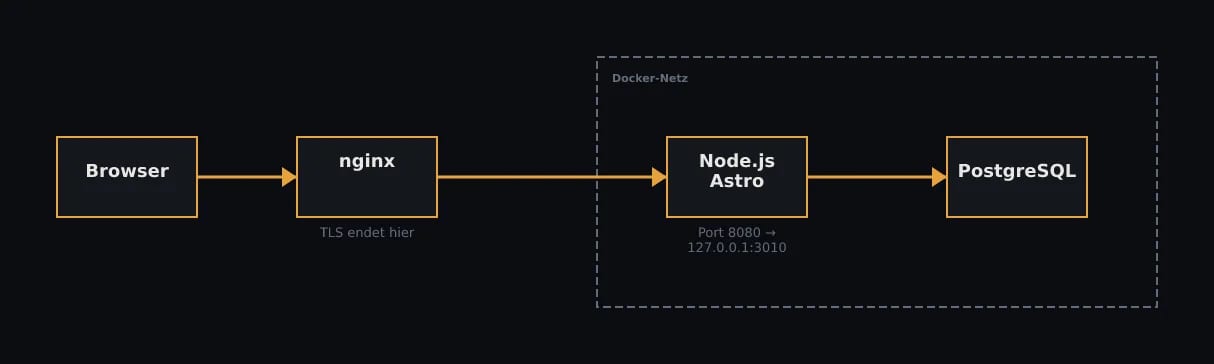
Neben dem Astro-Prozess läuft ein zweiter Container mit PostgreSQL 18. Erreichbar ist er nur im internen Docker-Netz, es gibt keinen Port, der nach außen zeigt — die Datenbank ist von außen schlicht nicht ansprechbar.
Schema und Migrationen verwalte ich mit Drizzle. Jede Migration läuft genau einmal, das wird in einer eigenen Tabelle in der Datenbank festgehalten. Wichtig ist, wann diese Migration läuft: direkt im Einstiegspunkt des Containers, noch bevor der erste Request bedient wird. Dadurch bleibt ein Deployment ein einziger Schritt — ich muss nicht daran denken, vorher noch irgendetwas manuell auszuführen.
Der gesamte Zustand des Blogs steckt in genau einem Docker-Volume. Das hat einen angenehmen Nebeneffekt fürs Sichern: Ich muss nicht wissen, welche Dateien wo liegen, ich muss nur dieses eine Volume sichern. Ein Cronjob macht das per pg_dump, regelmäßig und ohne dass ich daran denken muss.
Die Verwaltung unter /admin
Alles, was ich am Blog ändere, mache ich über einen Verwaltungsbereich. Dort schreibe ich Beiträge, schalte zwischen Entwurf und veröffentlicht um und sehe eine Vorschau in genau dem Layout, das später auch öffentlich zu sehen ist — keine Überraschungen beim Veröffentlichen.
Bilder lassen sich dort hochladen und in Ordner sortieren. Löschen geht nur, wenn kein Beitrag das Bild gerade benutzt — sonst würde ich mir aus Versehen kaputte Bilder in alten Beiträgen einhandeln. Kommentare erscheinen nirgendwo automatisch, jeder muss von mir freigegeben werden. Und auch Rubriken, die Reihenfolge der Navigation und die Orte auf der Weltkarte pflege ich dort.
Angemeldet bin ich über ein Passwort, das Sitzungscookie ist mit einem Schlüssel aus der Umgebung signiert. Ohne diesen Schlüssel startet der Container gar nicht erst — lieber ein Blog, der nicht startet, als eine Verwaltung mit einer Lücke.
Bilder: einmal rechnen, dann nur noch ausliefern
Was ich hochlade, landet in der Datenbank und übersteht damit jedes Deployment — ich muss keine Bilder separat mitschleppen. Beim Hochladen rechnet die Bibliothek sharp sofort mehrere Fassungen aus: AVIF und WebP in verschiedenen Breiten, dazu ein Vorschaubild für geteilte Links, etwa wenn jemand einen Beitrag in einem Chat teilt. Im laufenden Betrieb muss danach nichts mehr berechnet werden, das spart bei jeder einzelnen Anfrage Zeit.
SVG-Dateien nimmt die Verwaltung bewusst nicht an. Eine SVG-Datei kann Skripte enthalten, und ich will nicht jede Bilddatei einzeln daraufhin prüfen müssen. Und wenn ich ein Bild nachträglich in einen anderen Ordner verschiebe, ändert sich zwar sein Pfad, der alte Pfad bleibt aber trotzdem gültig — damit kein Verweis in einem alten Beitrag ins Leere zeigt.
Eine Schnittstelle, die nicht veröffentlichen kann
Ein Teil dieses Beitrags ist tatsächlich über genau die Schnittstelle entstanden, von der ich hier erzähle: Es gibt eine schmale Redaktions-API, über die ein Programm Entwürfe einreichen kann — neue Beiträge genauso wie Überarbeitungsvorschläge zu bereits veröffentlichten Texten.
Was diese Schnittstelle grundsätzlich nicht kann, ist mindestens so wichtig wie das, was sie kann: Sie kann nichts veröffentlichen, nichts löschen und keinen bereits veröffentlichten Text direkt ändern. Jeder Schreibvorgang darüber setzt den Zustand serverseitig auf “Entwurf” — egal, was das aufrufende Programm eigentlich vorhatte. Ohne einen gültigen Zugangstoken ist die Schnittstelle komplett abgeschaltet, jede ihrer Adressen antwortet dann nur mit einem Fehlercode.
Das ist für mich der eigentlich interessante Teil an dieser Konstruktion: Die Grenze steckt im Server, nicht in einer Absprache irgendwo in einem Skript. Selbst wenn ein Zugangstoken einmal verloren ginge, könnte damit jemand höchstens Entwürfe anlegen, die außer mir niemand zu sehen bekommt. Mehr Schaden ist mit diesem Token schlicht nicht möglich.
Der Container
Gebaut wird der Blog in einem zweistufigen Docker-Build: Eine Stufe installiert Abhängigkeiten und baut das Projekt, die zweite, deutlich schlankere Stufe enthält nur noch das fertige Ergebnis. Das Basisimage hängt dabei an einem festen Digest, nicht nur an einem Versions-Tag — derselbe Commit ergibt so auch in einem halben Jahr noch exakt dasselbe Image, unabhängig davon, was in der Zwischenzeit sonst noch veröffentlicht wurde.
Im Betrieb läuft der Container als normaler Benutzer namens node, nicht als root. Das Dateisystem ist schreibgeschützt, alle Berechtigungen (Capabilities) sind entzogen, und der Container darf sich selbst keine neuen Rechte mehr verschaffen. Nach außen hört er auf Port 8080, gebunden nur an 127.0.0.1:3010 auf dem Host — sichtbar von außen ist ausschließlich der nginx auf dem Host, der die Anfragen dorthin weiterreicht und die Verschlüsselung (TLS) beendet.
Zwei kleine, aber alltagstaugliche Adressen gehören noch dazu: Eine prüft beim Aufruf auch gleich die Datenbank mit, die andere verrät, welcher Softwarestand gerade läuft. Letztere ist aus einer ganz simplen, aber wiederkehrenden Frage entstanden: “Läuft die neue Version eigentlich schon?” — eine Frage, die ich sonst nur hätte beantworten können, wenn ich mich direkt auf dem Server umgesehen hätte.
Vom Tag bis zur laufenden Version
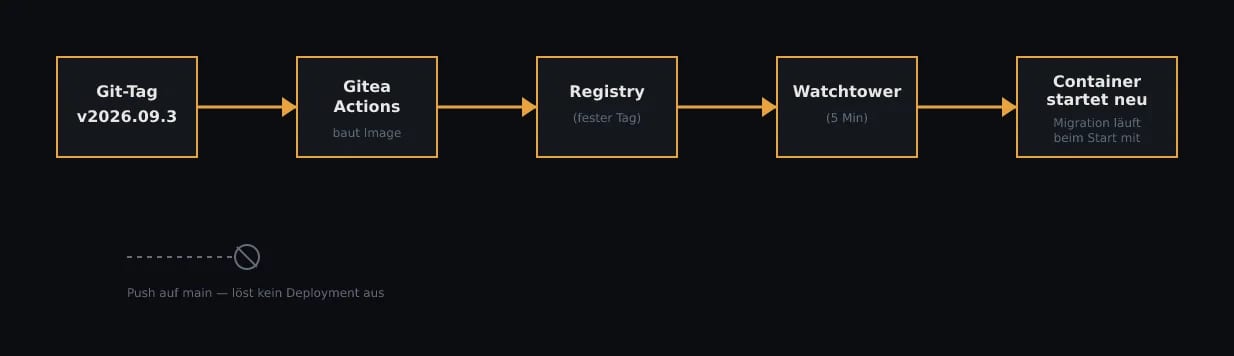
Am spannendsten finde ich die Kette, die aus einem einzelnen Befehl irgendwann eine laufende, aktualisierte Webseite macht:
- Ich pushe einen Versions-Tag nach dem Schema
vJAHR.MONAT.LAUFEND, zum Beispielv2026.09.3. - Gitea Actions baut daraufhin automatisch das Image und legt es in der eigenen Registry ab — unter dem festen Versionstag und zusätzlich unter
latest. - Watchtower, das auf dem Server im Hintergrund läuft, sieht alle fünf Minuten nach, ob sich hinter
latestein neues Image verbirgt. Findet es eines, holt es das Image und startet den Blog-Container neu. - Beim Neustart läuft, wie oben beschrieben, automatisch die Datenbankmigration mit.
Wichtig dabei: Nicht jeder Push auf den Hauptbranch geht live. Der Hauptbranch darf sich frei weiterentwickeln, produktiv wird ausschließlich das, was ich ausdrücklich mit einem Tag versehen habe. Das gibt mir einen klaren Moment der Entscheidung, statt dass jede Änderung sofort auf der öffentlichen Seite landet.
Und falls doch einmal etwas schiefgeht: Jede Version bleibt zusätzlich unter einem festen Tag erhalten. Ein Rollback bedeutet dann nur, eine Zeile in der Konfiguration zu ändern und umzuschalten — kein erneutes Bauen, kein Ausprobieren unter Zeitdruck.
Kleinigkeiten mit Folgen
Manche der interessantesten Probleme beim Aufbau dieses Blogs waren keine großen architektonischen Entscheidungen, sondern kleine Details, die erst im Zusammenspiel auffielen.
Eines davon war die Herkunftsprüfung bei Formularen. Astro prüft eingebaut, ob die Herkunft eines abgeschickten Formulars zur eigenen Adresse passt — und baut sich diese Adresse aus der Verschlüsselung der Verbindung, die beim Node-Adapter ankommt. Hinter einem nginx, der die Verschlüsselung (TLS) beendet und dem Container die Anfrage unverschlüsselt weiterreicht, kam dabei immer http:// heraus, während der Browser tatsächlich https:// geschickt hatte. Das Ergebnis: jedes abgeschickte Formular wurde abgelehnt. Gelöst habe ich das mit einer eigenen kleinen Zwischenschicht, die dieselbe Prüfung macht, sich dabei aber auf den Header X-Forwarded-Proto verlässt, den nginx mitschickt.
Ein zweites Beispiel war das Kartenskript für die Weltkarte mit den Reiseorten. Der Build hatte kleine Skript-Bausteine direkt in die Seite geschrieben, und genau das verbietet die eigene Sicherheitsrichtlinie (Content-Security-Policy) des Blogs, die nur Skripte aus eigenen Dateien erlaubt. Im Browser wurde das Skript dadurch stillschweigend blockiert, ganz ohne sichtbare Fehlermeldung — lokal beim Testen war davon nichts zu sehen, weil dort die Richtlinie anders eingestellt war.
Auch die Sichtbarkeit für Suchmaschinen ist ein bewusst gesetzter Schalter: Ohne ihn trägt jede Seite automatisch die Anweisung “nicht indexieren, keinen Links folgen”, und die robots.txt sperrt grundsätzlich alles. Das ist der sichere Ausgangszustand für Testinstanzen, die es bei einem Projekt wie diesem zwangsläufig auch gibt.
Und schließlich: Die Markenfarben des Blogs stehen an genau einer Stelle in einer einzigen Datei, aus der das eigentliche Stylesheet erzeugt wird. Wer diese erzeugte Datei einmal vergisst mitzucommitten, dem bricht der nächste Build ab — die Prüfung dafür läuft ganz bewusst vor jedem Build automatisch mit. Ein eigenes kleines Skript prüft dabei sogar, ob die Farbpaare des dunklen Erscheinungsbilds genug Kontrast haben, um gut lesbar zu bleiben. Das wird gemessen, nicht geschätzt.
Was das Ganze kostet — und was es bringt
Dieser Aufbau hat einen Preis: einen kleinen eigenen Server, ein Volume, um das ich mich kümmern muss, und im schlechtesten Fall bis zu fünf Minuten Verzögerung, bis eine neue Version tatsächlich online ist. Verglichen mit einem fertigen Dienst, bei dem ein Klick reicht, ist das mehr Aufwand.
Dafür steht zwischen meinem Text und den Lesern kein fremder Dienst, von dem ich abhängig bin. Alles lässt sich nachlesen, jede Entscheidung hat einen nachvollziehbaren Grund, und jede Version lässt sich jederzeit zurückdrehen. Für einen Blog, der genau davon handelt, was man selbst hosten und betreiben kann, fand ich das die passende Wahl.